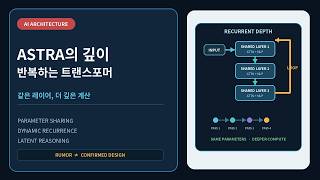
루프형 트랜스포머
같은 트랜스포머 층을 여러 번 반복해 통과시켜, 가중치는 작은 모델만큼만 저장하면서 더 깊은 모델처럼 계산하는 구조다. 메모리는 빠듯한데 작은 모델의 품질을 끌어올리고 싶을 때 쓰며, 일반 트랜스포머와 달리 저장 공간은 줄지만 계산량은 반복한 만큼 늘어난다.
| 항목 | 일반 트랜스포머 | 루프형 |
|---|---|---|
| 층 사용 | 각 층 한 번 | 같은 층 여러 번 |
| 저장하는 가중치 | 층 수만큼 | 적게 (재사용) |
| 실제 계산 깊이 | 층 수 | 층 수 × 반복 횟수 |
서로 다른 블록 L개를 T번 돌리면 블록 적용 횟수는 L×T가 된다. 일반 트랜스포머는 T=1인 경우다.
한 번 지나간 결과를 같은 층에 다시 넣어, 문단을 여러 번 다시 읽듯 표현을 다듬는다. recurrent depth, 깊이 방향 가중치 공유라고도 부른다.
메모리는 아끼지만 계산은 그대로 든다
반복하는 만큼 계산량도 늘어난다. 저장 공간은 작은 모델 크기로 유지되지만, 응답 속도와 연산 비용은 늘어난 깊이만큼 든다. 그래서 파라미터 수가 같은 모델을 이기는 건 쉬워도, 계산량이 같은 일반 모델을 이기는 게 진짜 과제다.
최근 Loopie 연구는 저장하는 층 수를 절반으로 줄이고, 아낀 몫을 MoE 구조에 다시 투자하는 방식으로 계산량이 같은 일반 트랜스포머를 앞섰다고 보고했다.
어디를 반복하느냐로 갈린다
| 방식 | 반복 단위 | 특징 |
|---|---|---|
| 유니버설 트랜스포머 | 블록 전체 | 토큰마다 멈출 시점을 따로 정한다 |
| 스택 루프 | 여러 층 묶음 | 디코더 전용 언어 모델에 맞춘 방식 |
| 층 루프 (Loopie) | 층 하나씩 | 한 층을 반복한 뒤 다음 층으로 넘긴다 |
| 순환 루프 (RLT) | 토큰 사이 | 이전 토큰의 상태를 다음 토큰에 넘긴다 |
RLT는 입력이 길어질수록 계산 경로도 길어지게 만들어, 입력마다 상태를 갱신해야 하는 상태 추적 문제를 노린다.
이럴 때 고려한다
메모리가 빠듯한 환경에서 작은 모델의 품질을 끌어올리고 싶을 때 후보가 된다. 3B급 모델이 층을 재사용해 파라미터를 늘리지 않고 용량을 키운 사례가 있다. 반대로 지연 시간이 가장 중요하다면 반복 횟수만큼 느려진다는 점부터 따져야 한다.
반복형 학습 알고리즘을 흉내 내야 하는 문제나, 학습 때보다 긴 입력을 풀어야 하는 문제에서도 쓰인다. 반복 구조가 알고리즘의 단계 반복과 잘 맞아, 더 적은 파라미터로 일반 트랜스포머와 비슷한 성능을 낸다는 연구가 있다.
'숨은 추론' 소문은 걸러 듣자
GPT-6 Astra가 루프형이라는 보도와 함께 추론 과정을 감춘다는 말도 퍼졌다. 그러나 라슈카는 루프 자체는 층을 재사용하는 작은 구조 변경일 뿐이고, 사고의 사슬을 감춘다는 설명도 반드시 맞지는 않다고 짚는다. 이론적으로도 루프가 사고의 사슬보다 새로운 능력을 주지는 않는다는 지적이 있다.
작은 모델과 구조 실험에서 주로 쓴다
아직은 완성된 제품보다 작은 모델을 직접 학습하거나 구조를 실험할 때 주로 쓰는 기법이다. 반복 횟수를 추론 때 바꿀 수 있는 모델이라면, 쉬운 입력은 적게 돌리고 어려운 입력은 많이 돌려 속도와 품질을 맞춘다.
| 어디서 | 어떻게 쓰나 |
|---|---|
| 메모리가 작은 기기의 모델 | 올려 둘 가중치는 작게 유지하고, 같은 층을 반복해 품질을 보탠다 |
| 모델 구조 연구 | 반복 단위와 횟수를 바꿔 가며 계산량이 같은 일반 모델과 비교한다 |
| 알고리즘·상태 추적 문제 | 단계를 여러 번 밟아야 하거나 입력이 긴 문제에서 반복 횟수를 늘려 푼다 |
| 추론 때 계산 조절 | 어려운 질문에만 반복을 더 돌려 더 오래 생각하게 한다 |