트랜스포머
2017년 구글 논문 Attention Is All You Need에서 나온 신경망 구조로, 예전 모델처럼 한 단어씩 차례로 읽지 않고 셀프 어텐션으로 문장 속 모든 단어가 서로를 한꺼번에 살펴본다. GPT·Claude·Gemini 같은 지금의 LLM이 모두 이 구조라서, 컨텍스트 길이 제한이나 토큰 요금이 왜 생기는지 알고 싶을 때 이해해 두면 좋다.
| 항목 | 이전 모델 (RNN, LSTM) | 트랜스포머 |
|---|---|---|
| 읽는 방식 | 한 단어씩 차례로 | 모든 단어를 한 번에 |
| 긴 문장 | 앞부분 내용을 잊어버림 | 멀리 떨어진 단어끼리도 바로 연결 |
| GPU로 나눠 학습하기 | 어렵다 | 쉽다 |
GPU로 나눠 학습하기 쉬운 덕분에 모델을 아주 크게 키울 수 있었고, 이것이 지금의 대형 LLM으로 이어졌다.
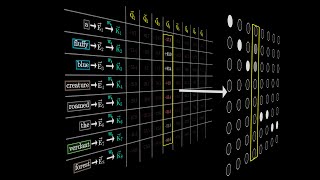
모든 단어가 서로를 본다
핵심 원리는 셀프 어텐션이다. 문장 속 단어 하나하나가 다른 모든 단어와 얼마나 관련 있는지 점수를 매긴다. 예를 들어 "그 개는 공을 쫓았다, 그것이 빨랐기 때문에"에서 '그것'이 개인지 공인지를 모델이 이 점수로 스스로 판단한다.
지금의 LLM은 이 구조로 '다음에 올 단어 하나'를 맞힌다. 단어 하나를 만들 때마다 같은 계산을 처음부터 다시 돌리고, 이것을 계속 이어 가면서 답변을 완성한다.
LLM을 쓰며 겪는 제약은 대부분 여기서 나온다
셀프 어텐션은 모든 단어 쌍을 서로 비교하기 때문에, 입력이 길어지면 계산량이 그보다 훨씬 빠르게 늘어난다(길이의 제곱). 사용자가 실제로 겪는 여러 제약이 바로 여기서 생긴다.
| 겪는 현상 | 이유 |
|---|---|
| 컨텍스트 길이에 상한이 있다 | 입력이 길어질수록 계산량이 크게 늘어난다 |
| 요금을 토큰 수로 매긴다 | 토큰이 늘수록 계산이 늘어난다 |
| 대화가 길면 비싸진다 | 앞에서 계산한 값(KV 캐시)을 메모리에 계속 쌓아 둔다 |
| 답변이 조금씩 끊겨 나온다 | 입력은 한 번에 읽지만 출력은 한 토큰씩 만든다 |
구조를 알면 비용과 품질을 아낄 수 있다
시스템 프롬프트나 참고 문서처럼 매번 똑같이 보내는 앞부분은 프롬프트 캐싱을 쓰면 비용을 줄일 수 있다. 바뀌지 않는 내용은 앞에, 매번 바뀌는 질문은 뒤에 두는 것이 좋다.
긴 문서를 넣으면 모델이 중간 내용을 자주 놓친다("Lost in the Middle"). 정말 중요한 내용은 문서 맨 앞이나 맨 끝에 두고, 꼭 필요한 부분만 잘라서 넣는 편이 더 정확하다.
대안이 나오고 있지만 아직은 트랜스포머
계산 비용이 크다는 약점 때문에, 입력 길이에 비례해서만 비용이 늘어나는 Mamba 같은 구조도 연구되고 있다. 실제 제품에는 트랜스포머와 섞은 형태로 쓰이기 시작했다. 그래도 2026년 현재 최상위 모델은 여전히 트랜스포머로 만들어지며, 이미지·음성 모델도 같은 구조를 쓴다.
챗봇부터 번역·이미지·음성까지 같은 구조
트랜스포머를 직접 만들어 쓰는 사람은 드물다. 대부분은 트랜스포머로 만든 모델을 통해 쓰며, 앞에서 본 제약에 맞춰 입력을 짜는 것이 실제로 쓰는 방법이다.
| 어디서 | 어떻게 쓰나 |
|---|---|
| LLM 챗봇·코딩 에이전트 | 질문·글쓰기·코드 작성에 쓴다. 대화가 너무 길어지면 요약해서 새로 시작해 비용을 줄이고 놓치는 내용도 줄인다 |
| 기계 번역 | 트랜스포머가 처음 겨냥한 작업으로, 문장 전체를 보고 자연스럽게 옮긴다 |
| 이미지·음성 모델 | 사진 설명, 음성 받아쓰기도 입력을 토큰처럼 잘게 나눠 같은 구조로 처리한다 |
| 사내 문서 검색 | 문서를 트랜스포머로 숫자 벡터(임베딩)로 바꿔 두고, 질문과 뜻이 비슷한 문서를 찾는다 |