임베딩
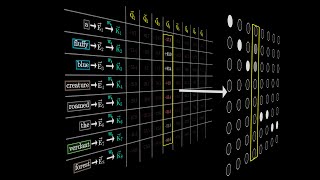
텍스트·이미지·코드를 숫자 목록(벡터)으로 바꾸는 기술로, 뜻이 비슷할수록 벡터끼리 가까워져 겹치는 글자가 없어도 같은 뜻의 문서를 찾을 수 있다. 키워드가 아니라 뜻으로 찾아야 할 때 쓰며, RAG 검색, 추천, 중복 문서 찾기가 모두 이 원리로 돌아간다.
| 검색 방식 | 잘 찾는 것 | 예시 |
|---|---|---|
| 임베딩(벡터) 검색 | 뜻이 같은 문서 | "파이썬 리스트 정렬" → "Python list sort" |
| 키워드 검색 | 정확히 같은 문자열 | 에러 코드 E4013, 제품 모델명 |
RAG에서는 쪼개고, 벡터로 바꾸고, 꺼내 쓴다
가장 흔한 사용처는 RAG다. 문서를 적당한 크기로 쪼개 벡터로 만들어 벡터 DB에 넣어 둔다. 질문이 들어오면 질문도 같은 모델로 벡터로 바꾸고, 가장 가까운 조각 몇 개를 꺼내 LLM에 함께 넘긴다.
코드로는 API 호출 한 번이면 된다. 예를 들어 text-embedding-3-large에 텍스트를 보내 벡터를 받고, Pinecone이나 pgvector 같은 벡터 DB에 저장하면 된다. 이미지와 텍스트를 한 공간에 넣는 모델을 쓰면 "노을 지는 바다"라는 문장으로 사진도 찾을 수 있다.
모델은 한 번 고르면 계속 같은 것을 쓴다
모델은 API로 쓰는 방식과 오픈 모델을 직접 띄우는 방식이 있다. 벤치마크 점수만 보지 말고 한국어 지원, 차원 수, 비용을 함께 따져 고른다. 반드시 지킬 규칙은 하나다. 문서를 저장할 때와 검색할 때 같은 모델을 써야 한다. 모델을 바꾸면 저장해 둔 문서를 전부 다시 임베딩해야 한다.
| 조절 방법 | 하는 일 | 효과 |
|---|---|---|
| 차원 줄이기 | 긴 벡터의 앞부분만 잘라 쓴다 | 품질은 조금만 떨어지고 저장 비용이 준다 |
| 양자화 | 숫자를 낮은 정밀도(int8, 바이너리)로 저장한다 | 저장량이 줄고 검색이 빨라진다 |
벡터 DB 저장 비용은 차원 수에 비례한다. 1,536차원 벡터 100만 건이면 벡터만 약 6GB다.
정확한 문자열은 키워드 검색과 섞어서 찾는다
에러 코드나 모델명처럼 글자 그대로 맞아야 하는 검색에서는 임베딩이 약하다. 그래서 실제 검색 시스템은 대부분 키워드 검색과 벡터 검색 결과를 합치는 하이브리드 검색을 쓴다. 더 정확하게 하려면 벡터 검색으로 후보 수십 개를 넓게 뽑은 뒤, 리랭커로 질문과의 관련도를 다시 매겨 순서를 정한다.
| 단계 | 도구 | 특징 |
|---|---|---|
| 1. 후보 넓게 찾기 | 임베딩 검색 | 미리 만들어 둔 벡터를 쓰니 빠르다 |
| 2. 순서 다시 매기기 | 리랭커 | 질문과 문서를 매번 짝지어 따지니 느리지만 정확하다 |
검색이 엉망이면 쪼개는 방식부터 본다
문서를 너무 잘게 쪼개면 앞뒤 맥락이 빠진 벡터가 되고, 너무 크게 쪼개면 여러 주제가 섞여 흐릿한 벡터가 된다. RAG 답변이 엉뚱한 문서를 근거로 든다면 LLM을 바꾸기 전에 임베딩 모델과 쪼개는 방식부터 점검하는 게 먼저다.
문서 검색부터 추천까지, 가까운 벡터를 찾는 곳이면 쓴다
가장 흔한 건 사내 문서를 임베딩해 두고 질문에 맞는 근거를 꺼내는 RAG 챗봇이다. 같은 벡터를 그대로 추천이나 중복 찾기에도 다시 쓸 수 있다.
| 어디서 | 어떻게 쓰나 |
|---|---|
| 사내 문서 검색·챗봇 | 문서를 쪼개 임베딩해 두고, 질문과 가까운 조각을 꺼내 LLM 답변의 근거로 넘긴다 |
| 코딩 에이전트·코드 검색 | 코드베이스를 임베딩해 "로그인 처리하는 곳"처럼 말로 관련 파일을 찾는다 |
| 추천 | 사용자가 본 글·상품과 벡터가 가까운 항목을 골라 보여준다 |
| 중복 찾기·분류 | 벡터가 아주 가까운 문의나 문서를 묶어 중복을 걸러내고 주제별로 나눈다 |