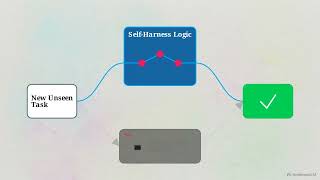
셀프 스캐폴딩 LLM
LLM이 자기를 감싸는 실행 구조(스캐폴드)를 작업마다 직접 짜고, 그 절차를 따라 문제를 푸는 방식이다. 사람이 하네스 하나를 고정해 설계하는 대신 버그 수정·기능 구현처럼 작업 유형별 진행 절차를 모델에게 맡기고 싶을 때 쓴다.
| 항목 | 사람이 만든 하네스 | 셀프 스캐폴딩 |
|---|---|---|
| 누가 설계하나 | 엔지니어 | 모델 |
| 작업별 차이 | 보통 하나로 고정 | 버그 수정·기능 구현마다 다르게 |
| 성능을 가르는 것 | 하네스를 얼마나 잘 짰나 | 모델이 학습한 절차 |
스캐폴드는 도구를 부르는 순서, 기억해 둘 중간 결과, 실패했을 때 다시 시도하는 방법을 정해 둔 프로그램이다. 지금까지는 사람이 직접 짰다.
좋은 답과 좋은 절차를 함께 배운다
대표 사례는 DeepReinforce가 MIT 라이선스로 공개한 코딩 모델 Ornith-1.0이다. 학습할 때마다 모델이 먼저 더 나은 스캐폴드를 제안하고, 그 스캐폴드를 따라 여러 풀이를 만든다. 풀이가 받은 보상은 스캐폴드를 제안한 단계에도 돌아간다.
그래서 모델은 답을 쓰는 법과 답에 이르는 절차를 쓰는 법을 같이 익힌다. 보상이 높은 스캐폴드가 살아남으면서, 사람이 튜닝하지 않아도 작업 유형별 전략이 생긴다는 것이 개발사의 설명이다.
바깥은 고정, 안쪽만 모델에게
모델이 절차를 직접 쓰면 테스트 기대값을 그대로 박아 넣는 식으로 채점을 속일 위험이 있다. 그래서 모델이 바꿀 수 있는 영역과 없는 영역을 확실히 나눴다. 직접 셀프 스캐폴딩을 실험한다면 이 원칙을 그대로 가져가면 된다.
| 구분 | 내용 |
|---|---|
| 고정 영역 (손대지 못함) | 실행 환경, 도구 목록, 테스트 격리 |
| 모델이 바꾸는 영역 | 기억 관리, 오류 처리, 작업 순서 |
| 감시 장치 | 규칙 기반 감시기 + 학습 중 바뀌지 않는 LLM 심판 |
성과는 아직 개발사 발표뿐이다
성적은 개발사가 정한 설정에서 잰 결과이고, 공개 시점에 독립적으로 재현된 결과는 없었다. 성과가 이 기법 덕분인지, 바탕이 된 기반 모델이 원래 강해서인지 가려 줄 비교 실험도 공개되지 않았다. LLM 심판이 모든 꼼수를 잡지 못한다는 점은 개발사도 인정한다.
오픈 웨이트는 가중치를 받을 수 있다는 뜻일 뿐, 학습 코드와 데이터까지 공개됐다는 뜻은 아니다. 셀프 스캐폴딩은 하네스 설계를 없애는 기술이 아니다. 사람이 고정할 경계와 모델에게 맡길 부분을 새로 나누는 기술로 보는 편이 맞다.
기존 에이전트에 연결해 써본다
Ornith-1.0은 Hugging Face에 여러 크기로 올라와 있고 FP8·GGUF 양자화 버전도 있다. 서버에서는 vLLM이나 SGLang으로 띄워 OpenAI 호환 엔드포인트를 만든 뒤, OpenHands나 OpenCode 같은 코딩 에이전트에서 기본 주소와 키만 바꾸면 된다.
| 환경 | 방법 |
|---|---|
| 서버·GPU | vLLM / SGLang → 기존 에이전트에 연결 |
| 노트북 | GGUF 버전을 llama.cpp, Ollama, LM Studio로 |
크기는 9B부터 397B까지 있다.