스케일링 법칙
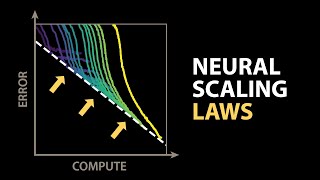
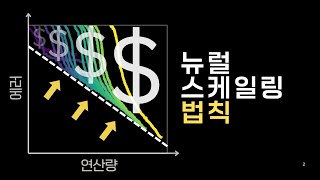
모델 크기, 학습 데이터, 계산량을 늘리면 성능이 얼마나 좋아질지 미리 계산할 수 있다는 경험 법칙이다. "클수록 좋다"가 아니라 "얼마나 좋아질지 예측된다"는 게 핵심이라, 큰 모델의 학습 규모를 정하거나 답할 때 생각하는 시간(추론 강도)을 얼마나 쓸지 판단할 때 기준으로 쓴다.
| 늘리는 것 | 언제 | 효과 |
|---|---|---|
| 모델 크기 | 학습할 때 | 오차가 일정한 비율로 줄어든다 |
| 학습 데이터 | 학습할 때 | 크기와 함께 늘려야 효율적이다 |
| 생각하는 시간 | 답할 때 | 정확도가 오르는 대신 비용·지연이 는다 |
작은 실험으로 큰 모델을 내다본다
계산량을 10배 늘릴 때마다 오차가 꾸준히 줄어서, 그래프로 그리면 거의 직선이 된다. 그래서 작은 모델 여러 개로 곡선을 그린 뒤 연장하면 큰 모델의 결과를 학습 전에 내다볼 수 있다.
직접 모델을 사전학습하거나 대규모 추가 학습을 한다면, 본 학습 전에 작은 규모로 곡선부터 그려보는 게 기본이다. 학습률이나 데이터 배합을 바꿀 때도 작은 모델에서 곡선이 어떻게 움직이는지 먼저 확인한다.
크기만 키우지 말고 데이터도 같이
예전에는 같은 예산이면 모델 크기에 더 쓰는 게 낫다고 봤다. 이후 연구에서 파라미터와 학습 데이터를 같은 비율로 늘려야 가장 효율적이라는 결론이 나왔다. 흔히 파라미터 1개당 토큰 약 20개가 균형점으로 꼽힌다.
요즘 오픈 모델은 이 균형점보다 훨씬 많은 데이터로 작은 모델을 학습시킨다. 학습은 한 번이지만 답하는 건 수없이 반복되니, 학습비를 더 써서라도 작고 똑똑한 모델을 만드는 게 전체로는 싸다. 노트북에서 돌아가는 고성능 소형 모델이 많은 이유다.
80억 파라미터 모델의 학습 토큰 수. 균형점의 75배를 학습했는데도 성능이 계속 올랐다.
API에서는 생각하는 시간을 조절한다
사전학습을 키우는 데 한계가 보이자, 답할 때 더 오래 생각하게 하는 방식이 대안으로 떠올랐다. 개발자가 가장 직접 다루는 스케일링이 이것이다. API에서 추론 강도(effort)나 사고 토큰 예산을 바꿔 작업마다 맞추면 된다.
| 작업 | 추론 강도 | 이유 |
|---|---|---|
| 까다로운 버그 추적, 설계 검토 | 높게 | 비용을 더 써서 정확도를 산다 |
| 단순 분류, 요약 | 낮게 | 빠르고 싸게 |
답을 여러 개 만들고 테스트를 통과한 것만 고르는 방식도 같은 원리다. 계산을 더 쓰는 만큼 정답률이 오른다.
법칙이 말해주지 않는 것
이 법칙이 예측하는 건 평균적인 오차일 뿐, 특정 능력이 언제 생길지는 알려주지 않는다. 또 데이터 품질과 학습 방법이 그대로라는 전제에서만 맞는다. 같은 계산량이라도 데이터를 잘 거르거나 구조를 바꾸면 결과가 더 좋아질 수 있다. 규모는 강력한 수단이지만 유일한 수단은 아니다.
학습 계획과 추론 비용을 정하는 잣대로 쓴다
실제로 쓰는 장면은 크게 두 가지다. 모델을 학습시키기 전에 규모와 데이터 양을 정할 때, 그리고 만든 모델을 쓸 때 계산을 얼마나 더 들일지 정할 때다.
| 어디서 | 어떻게 쓰나 |
|---|---|
| 사전학습·대규모 추가 학습 | 작은 모델 몇 개로 곡선을 그려 본 학습의 크기와 데이터 양을 정한다 |
| 소형 모델 만들기 | 균형점보다 데이터를 훨씬 많이 넣어, 답할 때 싸고 빠른 모델을 만든다 |
| API 앱·코딩 에이전트 | 어려운 단계만 추론 강도를 높이고, 단순 작업은 낮춰 비용을 맞춘다 |
| 코드 생성 | 답을 여러 개 만들고 테스트를 통과한 것만 골라 정답률을 올린다 |