시맨틱 검색
단어가 똑같은지가 아니라 뜻이 가까운지로 찾는 검색으로, "노트북 추천"으로 검색해도 "laptop 구매 가이드" 같은 문서를 찾아 준다. 사용자가 문서와 다른 표현으로 묻거나 RAG에서 AI에게 관련 자료를 찾아 줘야 할 때 쓴다.
| 구분 | 키워드 검색 | 시맨틱 검색 |
|---|---|---|
| 찾는 기준 | 단어 일치 | 의미의 가까움 |
| 강한 곳 | 제품 코드, 이름, 정확한 문구 | 다르게 표현한 질문, 동의어 |
| 약한 곳 | 바꿔 말한 표현 | 고유명사, 숫자, 짧은 코드 |
| 준비물 | 검색 색인 | 임베딩 모델 + 벡터 저장소 |
문장을 숫자로 바꿔 거리를 잰다
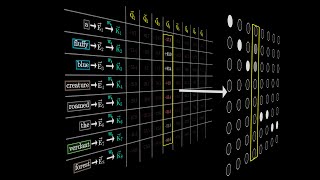
핵심은 임베딩이다. 임베딩 모델이 문장을 숫자 목록(벡터)으로 바꾸는데, 뜻이 비슷한 문장일수록 벡터끼리 가깝게 놓인다. 그래서 검색은 질문 벡터와 가장 가까운 문서 벡터를 고르는 일이 된다.
| 순서 | 할 일 |
|---|---|
| 1. 문서 쪼개기 | 긴 문서를 문단 단위 조각으로 나눈다 |
| 2. 임베딩 저장 | 조각마다 벡터로 바꿔 벡터 DB에 넣는다 |
| 3. 질문 변환 | 검색어도 같은 모델로 벡터로 바꾼다 |
| 4. 가까운 순 반환 | 거리가 가까운 조각부터 돌려준다 |
문서와 질문은 반드시 같은 임베딩 모델로 바꿔야 한다. 모델을 바꾸면 저장된 문서도 전부 다시 임베딩해야 한다.
실제로는 키워드 검색과 섞어 쓴다
시맨틱 검색만 쓰면 오류 코드나 사람 이름처럼 정확히 맞아야 하는 검색에서 엉뚱한 결과가 나오기 쉽다. 그래서 키워드 검색 결과와 벡터 검색 결과를 합치는 하이브리드 검색이 흔한 방식이다.
Elasticsearch나 OpenSearch를 이미 쓰고 있다면 벡터 검색 기능을 추가해 하이브리드로 바꿀 수 있고, 새로 시작한다면 Pinecone 같은 벡터 DB를 써도 된다. 찾은 결과를 한 번 더 정렬하는 리랭커를 붙이면 상위 결과가 더 정확해진다.
품질은 임베딩 모델과 쪼개는 방식이 좌우한다
같은 검색 엔진이라도 어떤 임베딩 모델을 쓰느냐에 따라 결과가 크게 달라진다. 코드·의료·법률처럼 전문 용어가 많은 분야는 그 분야에 맞는 모델을 고르고, 한국어 문서라면 한국어를 잘 다루는 모델인지 먼저 확인한다.
조각을 너무 길게 자르면 여러 주제가 섞여 뜻이 흐려지고, 너무 짧게 자르면 맥락이 사라진다. 실제로 들어올 질문 수십 개로 결과를 직접 확인하면서 모델과 조각 크기를 맞추는 것이 가장 확실하다.
가장 흔한 건 RAG 챗봇의 자료 찾기
가장 많이 쓰는 곳은 RAG 챗봇의 자료 찾기 단계다. 질문과 뜻이 가까운 문서 조각 몇 개를 찾아 AI에게 넘기면, AI가 그 내용을 근거로 답한다.
| 어디서 | 어떻게 쓰나 |
|---|---|
| RAG 챗봇 | 질문과 가까운 조각을 몇 개 골라 프롬프트에 넣고, 그 내용을 근거로 답하게 한다 |
| 사내 문서 검색 | 규정·위키·회의록을 조각내 저장해 두고, 직원이 평소 말투로 물어도 맞는 문단을 찾아 준다 |
| 쇼핑·고객 지원 검색 | "출퇴근용 가벼운 가방" 같은 질문을 비슷한 상품이나 FAQ로 연결하고, 모델명 검색은 키워드 검색으로 보완한다 |
| 코드 검색 | "로그인 처리하는 부분"처럼 설명으로 물어 관련 코드 조각을 찾는다 |