파티클 1
Particle AI가 DeepSeek V4.1 Flash를 추가 학습시켜 만든 소프트웨어 엔지니어링용 모델이다. 같은 코딩 작업을 평균 약 45% 적은 토큰으로 끝내야 해서 작업당 비용과 대기 시간을 줄이고 싶을 때 쓴다.
| 항목 | DeepSeek V4.1 Flash | Particle-1 |
|---|---|---|
| 관계 | 기반 모델 | 이를 포스트 트레이닝 |
| 평균 사용 토큰 | 기준 | 약 45% 적음 |
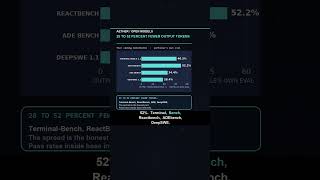
| 작업당 평균 비용 | 기준 | 약 34~52% 낮음 |
| 작업 통과율 | 기준 | 오차 범위 안에서 비슷 |
모두 Particle이 자체 평가한 4개 벤치마크 기준이다.
덜 고민하고, 끝나면 바로 멈춘다
Particle은 내부에서 만든 강화학습 환경에서 '정확도는 지키면서 토큰을 덜 쓰는' 쪽으로 모델을 훈련했다. 그 결과 모델의 행동이 두 가지 면에서 달라졌다.
| 바뀐 행동 | 의미 |
|---|---|
| 같은 행동에 덜 숙고 | 다음 단계를 고르고 실행하는 고민이 짧아, 행동 수가 같거나 늘어도 토큰은 준다 |
| 검증 뒤 바로 종료 | 해결을 확인한 다음 결정을 되짚거나 확인을 반복하거나 긴 마무리 글을 쓰지 않는다 |
비용만 주는 게 아니라 작업 자체가 더 빨리 끝나서, 결과를 기다리는 사람에게도 이득이라는 게 Particle의 설명이다.
코딩부터 시작한 첫 모델
Particle-1은 Particle AI가 2026년 10월 28일 공개한 첫 모델이다. 지금은 소프트웨어 엔지니어링에 맞춰져 있고, 다른 분야로 넓힐 계획이라고 밝혔다. Particle AI는 포스트 트레이닝과 추론 최적화로 AI 실행 비용을 낮추려는 인프라 회사다. 뉴스 앱 Particle News나 IoT 플랫폼 Particle처럼 이름만 같은 다른 회사와 헷갈리지 않도록 주의한다.
API나 게이트웨이로 호출
Particle 자체 API로 쓸 수 있고, Vercel AI Gateway에도 Particle.AI가 제공자로 올라 있어 게이트웨이 키 하나로 다른 모델과 바꿔 가며 부를 수 있다. 게이트웨이 목록의 Particle 제공 모델은 deepseek/deepseek-v4.1-flash-1017처럼 DeepSeek 이름으로 표시되므로, 어떤 ID가 Particle-1인지는 호출 전에 확인하는 게 좋다.
절감률은 직접 재 봐야 한다
절감 폭은 작업에 따라 출력 토큰 기준 약 28%에서 52%까지 차이가 크고, 수치는 모두 Particle 자체 평가다. 직접 테스트했더니 오히려 비용이 더 나왔다는 사용자 영상도 있다. 내 작업으로 기반 모델과 나란히 돌려 토큰·비용·성공률을 비교한 뒤 바꾸는 게 안전하다.
사람들은 주로 이렇게 쓴다
| 어디서 | 어떻게 쓰나 |
|---|---|
| 코딩 에이전트 | 버그 수정·기능 구현처럼 여러 단계 작업을 맡겨, 끝난 뒤 장황한 확인 없이 멈추는 특성으로 토큰을 아낀다 |
| 모델 교체 비교 | DeepSeek V4.1 Flash와 같은 작업을 돌려 작업당 비용과 통과율을 나란히 잰다 |
| Vercel AI Gateway | 기존 게이트웨이 설정에서 모델 ID만 바꿔 끼워 비용 차이를 확인한다 |