어텐션 헤드
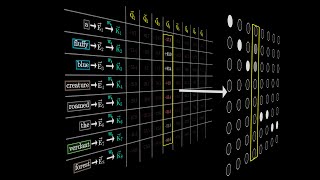
어텐션 헤드는 트랜스포머 안에서 단어 사이의 관계를 계산하는 가장 작은 단위로, 각 층에 여러 개가 들어 있어 무엇을 가리키는지, 문법, 위치 같은 관계를 하나씩 맡는다(멀티헤드 어텐션). 모델이 어떻게 판단하는지 들여다보거나 긴 대화에서 메모리 비용이 왜 생기는지 이해할 때 알아 두면 좋다.
| 관계 종류 | 예시 |
|---|---|
| 무엇을 가리키는지 | "it" → "cat" |
| 문법 관계 | 동사와 목적어 |
| 위치 관계 | 바로 앞뒤 단어 |
"The cat sat on the mat because it was tired"에서 "it"이 고양이인지 매트인지 알려면 단어 사이의 관계를 봐야 한다. 이런 관계를 헤드들이 나눠서 계산한다.
검색어·분류표·내용으로 점수를 매긴다
헤드는 토큰마다 세 가지를 만든다. 도서관에 비유하면 Query는 검색어, Key는 책등의 분류표, Value는 책 내용이다. 내 Query와 잘 맞는 Key를 가진 토큰의 Value를 더 많이 가져와 섞는 것이 계산의 전부다.
헤드마다 점수를 매기는 기준이 다르게 학습되므로, 같은 문장을 봐도 헤드마다 주목하는 곳이 다르다. PyTorch에서는 torch.nn.MultiheadAttention에 임베딩 차원과 헤드 수를 넣으면 이 구조가 만들어진다.
열어 보면 헤드끼리 일을 나눠 맡고 있다
역할을 정해 주지 않아도 학습이 끝나면 헤드들은 일을 나눠 맡는다. 바로 앞 토큰만 보는 헤드, 문장 부호를 보는 헤드, 멀리 떨어진 지시어와 명사를 잇는 헤드가 따로 있다.
그중 인덕션 헤드는 "앞에서 A 다음에 B가 나왔으면, A가 다시 나올 때 B를 예측"한다. 프롬프트에 좋은 예시를 넣으면 답이 좋아지는 현상도 상당 부분 이 헤드들로 설명된다.
헤드가 많으면 긴 대화에서 메모리를 많이 쓴다
헤드가 많을수록 표현력은 좋아진다. 대신 답을 만드는 동안 모든 헤드의 Key·Value를 KV 캐시로 GPU 메모리에 들고 있어야 한다. 컨텍스트가 길어지면 이 캐시가 병목이 되므로, 최신 모델은 헤드를 공유하거나 압축하는 쪽으로 설계된다.
| 방식 | 하는 일 | 효과 |
|---|---|---|
| GQA | Query 헤드 여러 개가 Key·Value 헤드 하나를 같이 쓴다 | 캐시가 몇 분의 일로 준다 |
| MLA | Key·Value를 작게 압축해 저장했다가 필요할 때 되살린다 | 캐시 메모리가 준다 |
직접 볼 수 있지만, 점수가 곧 이유는 아니다
BertViz에 문장을 넣으면 층별·헤드별 어텐션이 단어를 잇는 선의 굵기로 그려진다. Hugging Face transformers에서는 output_attentions=True를 주면 어텐션 행렬을 그대로 받아 볼 수 있다.
다만 어떤 단어에 어텐션 점수가 높다고 해서 그 단어가 결정에 중요했다는 보장은 없다. 모델이 왜 그렇게 답했는지 확정하는 근거로 보지 말고, 행동을 이해하는 단서 중 하나로만 보는 것이 안전하다.
모델을 뜯어보고 메모리를 어림할 때 쓴다
어텐션 헤드를 직접 다룰 일은 대개 모델 속을 들여다볼 때와 서빙 메모리를 계산할 때다. 프롬프트를 짤 때도 헤드의 동작을 알면 예시를 왜 넣는지 이해하기 쉽다.
| 어디서 | 어떻게 쓰나 |
|---|---|
| 모델 해석·디버깅 | BertViz나 output_attentions=True로 헤드별 어텐션을 그려 모델이 어디를 보는지 단서를 찾는다 |
| 모델 직접 구현 | 임베딩 차원이 헤드 수로 나누어떨어지게 맞춰 헤드 수를 정한다 |
| LLM 서빙 | 헤드 수와 GQA 사용 여부로 KV 캐시 크기를 어림해 컨텍스트 길이와 동시 요청 수를 정한다 |
| 프롬프트 작성 | 인덕션 헤드가 앞의 패턴을 따라 하므로, 원하는 답 형식의 예시를 프롬프트에 넣는다 |