지속 학습
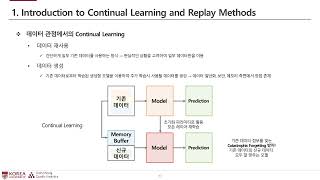
새 데이터와 과제를 차례로 배우면서도 예전에 배운 것을 잊지 않게 하는 학습 방식으로, 모델을 여러 번 이어서 파인튜닝하거나 쓸수록 나아지는 AI를 만들려 할 때 부딪히는 문제다. 신경망은 새로 배우면 예전 패턴을 덮어쓰는 파국적 망각이 생기기 때문에, 지금의 LLM은 학습이 끝나면 가중치를 고정한 채 배포된다.
| 방식 | 가중치 변경 | 이럴 때 쓴다 |
|---|---|---|
| RAG·메모리 파일 | 없음 | 가격표, 사내 규정처럼 자주 바뀌는 사실 |
| 파인튜닝 | 있음 | 말투, 출력 형식, 도메인 특유의 추론 방식 |
| 진짜 지속 학습 | 실시간 | 아직 연구 단계 |
배포된 모델이 아는 것은 학습 때 본 지식과 지금 대화에 들어 있는 내용뿐이다. 새 지식을 넣으려면 위 세 방식 중 하나를 고르게 된다.
계속 파인튜닝하면 예전 실력이 떨어진다
사내 문서를 학습시킨 뒤 다음 분기 문서, 이어서 상담 말투까지 차례로 학습시키면 마지막 과제는 잘한다. 대신 원래 잘하던 일반 추론이나 코딩 실력이 눈에 띄게 떨어지는 경우가 흔하다. 모델이 지금 보는 데이터에만 맞춰지기 때문이다.
파인튜닝할 때 망각을 줄이는 요령
실무에서는 아래 방법을 함께 쓴다. 과제마다 LoRA 어댑터를 따로 만들어 두고 요청에 맞춰 갈아 끼우면 과제끼리 서로 방해하는 일 자체가 줄어든다.
| 방법 | 어떻게 | 효과 |
|---|---|---|
| 데이터 섞기 | 이전 데이터나 범용 지시문 일부를 함께 학습 | 예전 능력을 다시 떠올리게 함 |
| 낮은 학습률 | 가중치를 조금씩만 고침 | 덮어쓰기를 줄임 |
| LoRA | 원본 가중치를 건드리지 않음 | 덜 배우는 대신 덜 잊음 |
| 강화학습(RL) | 모델이 직접 만든 답으로 학습 | 지도 파인튜닝보다 덜 잊는다는 연구가 있음 |
기억을 붙이는 것과 배우는 것은 다르다
"쓸수록 똑똑해지는 AI"라고 홍보하는 제품 중 상당수는 가중치를 바꾸지 않는다. 대화를 외부 메모리에 적어 두었다가 다시 꺼내 쓰거나, CLAUDE.md 같은 파일에 규칙을 쌓아 두는 방식이다. 실용적이지만 검색이 빗나가면 소용없고, 기억이 쌓일수록 컨텍스트 비용이 커진다.
실시간으로 배우는 모델은 아직 연구 중
구글의 네스티드 러닝처럼 빠르게 바뀌는 기억과 천천히 굳는 기억을 나누는 연구가 나오고 있지만 아직 실험 단계다. 대화하면서 가중치를 바로 고치면 잘못된 정보나 악의적인 데이터까지 배울 수 있다. 그래서 무엇을 배우게 할지 통제하는 방법도 함께 풀어야 한다.
실무에서는 망각을 피해 가는 방식으로 쓴다
실시간으로 가중치를 고치는 진짜 지속 학습은 아직 쓰기 어렵다. 그래서 사람들은 주로 바뀌는 사실은 바깥에 두고, 꼭 필요한 능력만 망각을 줄이며 파인튜닝하는 식으로 이 문제를 다룬다.
| 어디서 | 어떻게 쓰나 |
|---|---|
| 사내 문서 검색 | 규정·가격표가 바뀌면 다시 학습하지 않고 RAG 문서만 갈아 끼운다 |
| 코딩 에이전트 | 프로젝트 규칙과 자주 하는 실수를 메모리 파일에 쌓아 두고 다음 세션에 다시 읽힌다 |
| 도메인 모델 파인튜닝 | 새 데이터를 학습할 때 범용 지시문을 섞고 학습률을 낮춰 원래 실력을 지킨다 |
| 한 모델로 여러 과제 | 과제별 LoRA 어댑터를 따로 만들어 요청에 맞춰 갈아 끼운다 |
- What is Continual Learning? – IBM 튜토리얼
- Continual Learning with RL for LLMs 블로그
- RL's Razor: Why Online Reinforcement Learning Forgets Less (arXiv:2509.04259) 논문
- LoRA Learns Less and Forgets Less (arXiv:2405.09673) 논문
- Introducing Nested Learning: A new ML paradigm for continual learning – Google Research 공식